Java kann nicht auf null skalieren? Diese Quarkus-App sieht das anders.
Eine Solo-Session: ein Reisebudget-Tracker für die Familie, gebaut mit Quarkus, Qute und Firestore, deployt auf Google Cloud Run und zweimal im Billing-Dashboard bei 0 € bestätigt. Zero Cost hat gehalten, und das Google-Login machte mehr Ärger als der App-Code.
YouTube
Java kann nicht auf null skalieren? Diese Quarkus-App sieht das anders.
YouTube-Video laden
Dieses Video wird von YouTube eingebettet und erst nach Ihrer Einwilligung geladen. Beim Laden können personenbezogene Daten an YouTube oder Google übermittelt und Cookies gesetzt werden.
Mehr dazu in der Datenschutzerklärung.
Projektquelle
Arbeits-Repository
Hier findest du Prompts, Instructions und Beispiele aus dem gezeigten Modernisierungs-Workflow.
Repository öffnenTimestamps der Session
- 00:00Einführung
- 01:22Warum ein Zero-Cost-Budget-Tracker: die Familienurlaubs-Geschichte
- 04:21Der Plan: Bauen und Deployen komplett mit KI
- 05:52GCP-Projekt-Setup und das Zero-Cost-Ziel
- 07:58Der Build-Prompt für GitHub Copilot
- 34:52Erster lokaler Startversuch und Firestore-Credential-Fehler
- 50:27App läuft lokal: Familienmitglieder, Budgets, Layout-Fixes
- 53:51Die KI GCP-Infrastruktur und CI/CD aufsetzen lassen
- 1:04:04Code-Walkthrough: Records und Firestore-Repository-Struktur
- 1:11:01GitHub-Actions-Workflow und erstes Cloud-Run-Deployment
- 1:18:52Live-Test der App und Bestätigung der Nullkosten
- 1:28:22Google-Login hinzufügen: Copilot-Probleme und IDE-Abstürze
- 1:41:14Wechsel zu Claude Code für die OAuth-Implementierung
- 1:44:19OAuth-Client-Setup und GitHub-Secrets
- 1:52:45Debugging von OIDC-Konfigurationsfehlern und Credential-Mismatches
- 2:14:21Login funktioniert endlich: Multi-User-Test mit Zuschauern
- 2:17:11Cold-Start-Zeit messen
- 2:21:12Zusammenfassung und Abschluss
Ein Familienurlaub in England, eine Woche vor dieser Session, war der Auslöser. Meine Kinder wollten Sachen kaufen und hatten keine Ahnung, wie viel Budget sie noch hatten. Ich habe es mit einer To-do-App mitgeschrieben, das funktionierte, war aber chaotisch. Ich bin auch geizig, was meine eigenen Nebenprojekte angeht: Ich zahle nichts dafür, ein Projekt nur für mich selbst zu hosten, will es aber trotzdem von überall erreichbar haben, für Familie und Freunde, ohne Kosten.
Diese Session hatte deshalb drei Regeln. Bauen mit einem KI-Coding-Tool, nicht von Hand. Erst lokal zum Laufen bringen. Und das komplette Cloud-Setup, Projekt, OAuth-Client, Cloud-Run-Deployment, ebenfalls über die KI, nicht über die GCP-Konsole oder auswendig gelernte gcloud-Befehle.
So sieht das Ganze im Zusammenspiel aus:
Der Stack, gewählt wegen der Kosten, nicht aus Gewohnheit
Jede Entscheidung hier hielt die laufenden Kosten bei null. Der Build blieb beim normalen JVM-Weg von Quarkus, ohne Native Image: Native Builds vertragen sich schlecht mit Reflection, und genau darauf setzen die Google-Cloud-Client-Bibliotheken, die dieses Projekt braucht. Immer wieder versuche ich, ein Native Image zu bauen, und es funktioniert nie richtig. Mein üblicher Quarkus-Cold-Start liegt sonst unter zwei Sekunden, das war also das Ziel auf der JVM.
Bei der UI hat sich Qute gegen Vaadin durchgesetzt. Ich bevorzuge Vaadin von Hand, aber in Kombination mit KI-Tools hat es mir schon Ärger gemacht: Lizenzprobleme, fehlende Annotationen, die die KI nicht erkannt hat. Mit KI kann ich es im Moment nicht empfehlen. Qute ist nah genug an reinem HTML, dass die KI es zuverlässig generiert.
Firestore statt einer SQL-Datenbank ist die Entscheidung, die "keine Kosten im Leerlauf" wahr macht: Eine SQL-Instanz kostet, solange sie läuft, egal ob genutzt oder nicht, Firestore nicht. Das Google-Login setzt darauf auf, über Quarkus' eigene quarkus-oidc-Extension mit provider=google: keine zusätzliche Bibliothek, keine selbstgeschriebene Credential-Verwaltung.
Nichts davon war vorher geprobt. Ich hatte Grok 4.6 vor diesem Stream noch nie benutzt, das Modell, mit dem GitHub Copilot im Autopilot-Modus lief, und Google Cloud hatte ich vorher auch noch nie ernsthaft genutzt.
Die App stand schnell. Das Login nicht.
Der erste lokale Start scheiterte an Firestore-Credential-Fehlern: keine Application Default Credentials lokal. Die Lösung war einfach: lokale Entwicklung auf einen In-Memory-Store umstellen, kein Docker, keine echten Credentials nötig. Auch das Datenmodell brauchte einen Fix. Budget und Ausgaben waren über die ganze Familie geteilt statt pro Person, was überhaupt keinen Sinn ergab, sobald ich es ausprobiert habe. Jedes Familienmitglied bekam sein eigenes Budget, eigene Ausgaben, optionales Einkommen, modelliert als unveränderliche Java-Records, nah an Event Sourcing.
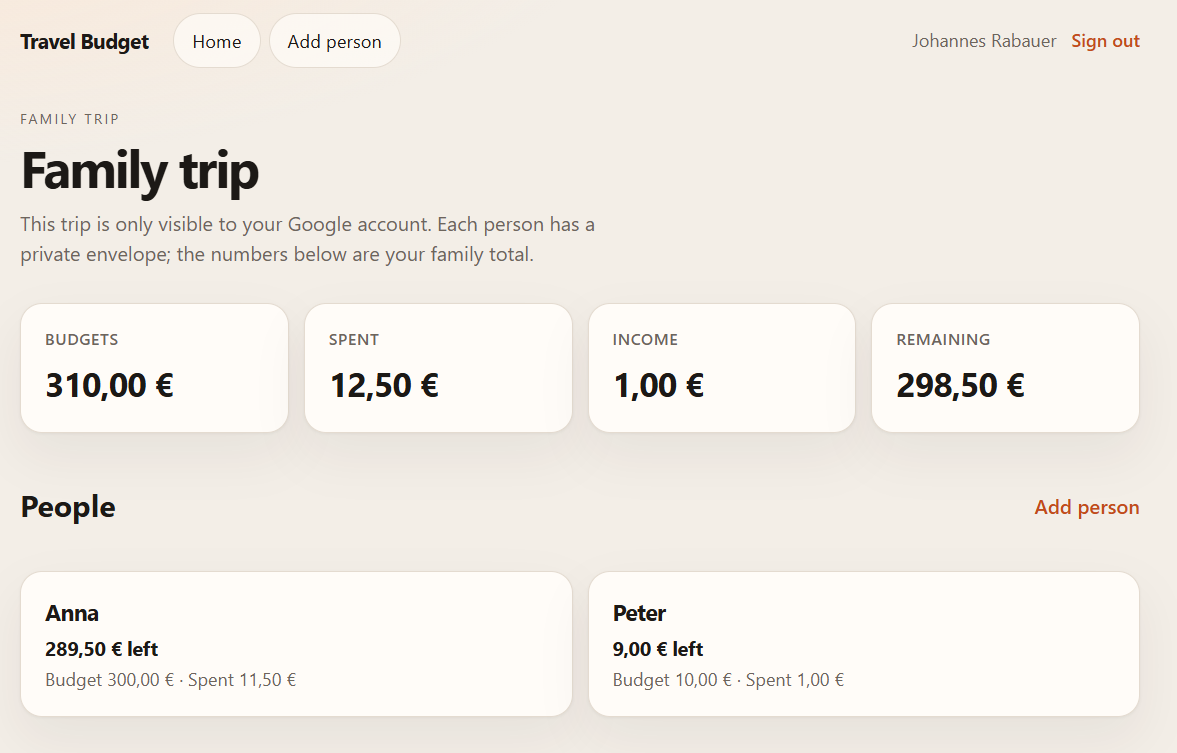 Das Familien-Dashboard: eine gemeinsame Reise, ein privates Budget pro Person.
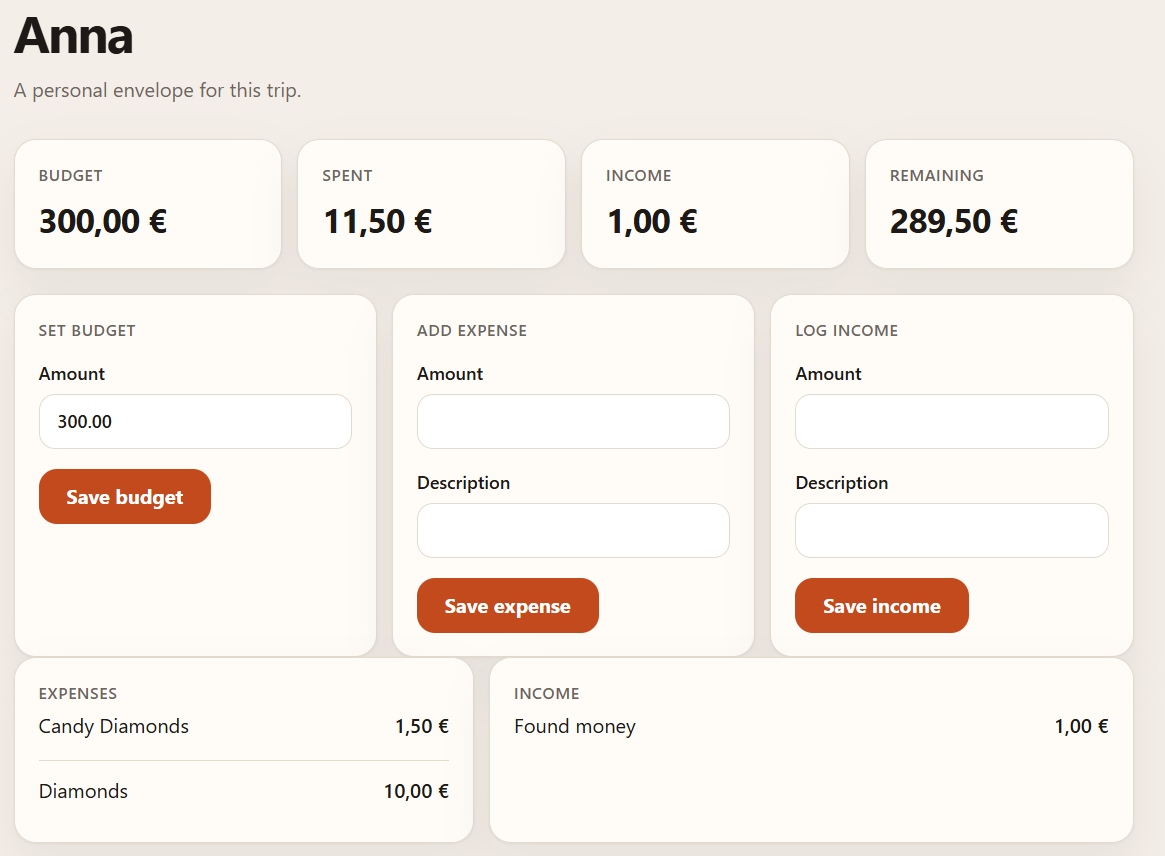 Annas eigenes Budget: Budget, Ausgaben, Einkommen und was übrig bleibt.
Das Bereitstellen der Cloud-Seite war ein einziger Prompt: alles Nötige in Google Cloud einrichten, dazu einen GitHub-Actions-Workflow, der bei jedem Push auf main deployt. Gebaut mit Maven auf Java 21, deployt auf Cloud Run in europe-west mit CPU-Boost und --min-instances=0. Das erste Deployment funktionierte. Das Billing-Dashboard für die letzten sieben Tage zeigte 0 €.
Beim Google-Login ist der Ansatz "die KI macht alles" zerbrochen. Copilots Browser-Canvas-Ansicht, die für mich durch die Google-Cloud-Konsole klicken sollte, ist mitten im Ablauf immer wieder abgestürzt. Einmal so heftig, dass die ganze Copilot-Session weg war und ich mich neu einloggen musste. Ich bin hier etwas enttäuscht, sagte ich im Stream, bevor ich es ein letztes Mal versuchte und zu Claude Code wechselte.
Claude Code konnte den OAuth-Client auch nicht selbst anlegen, aus einem ehrlicheren Grund: Es ist ein manueller Schritt in der Google-Cloud-Konsole, ohne API-Abkürzung. Also habe ich es selbst gemacht, den Stream zweimal stummgeschaltet, um das Secret zu verbergen, und Claude die Werte dann als GitHub-Secrets speichern lassen statt sie in den Chat zu tippen.
Genau darum geht es im Diagramm oben. Jede andere Box in diesem Projekt lief über einen Prompt. Diese eine nicht, und genau dort begann das Debugging. Zuerst scheiterte ein Deployment an einem nicht beworbenen OAuth-"End-Session-Endpoint", für den ich keine saubere Lösung fand. Dann funktionierte der Login, brachte danach aber ein "Resource not found". Dann entpuppte sich ein Credential-Mismatch als Copy-Paste-Artefakt: Ich hatte das Client-Secret über die Windows-cmd statt über PowerShell kopiert, was versteckte Zeichen im Wert hinterließ. PowerShell behob es, der Login funktionierte durchgehend. Zuschauer, darunter "Suzan", "Sumi" und "Mr. SK", meldeten sich mit ihren eigenen Google-Konten an und legten eigene Daten an.
Das Billing zeigte danach wieder 0 €. Ehrliche Lücke: Das Datenmodell trennt mehrere unabhängige Familien noch immer nicht sauber. Es hat für alle Zuschauer beim Live-Test funktioniert, aber die Familien-/Reise-ID ist an Stellen noch hartkodiert, die ich selbst beim Code-Walkthrough benannt habe.
Der Cold Start hat mein eigenes Ziel verfehlt
Ich hatte mich vorbereitet: AppCDS, den Firestore-gRPC-Kanal beim Start in einem Hintergrund-Thread vorgewärmt, Cloud Runs CPU-Boost, alles auf unter zwei Sekunden ausgerichtet. Als ich die Instanz live herunter- und wieder hochfahren ließ, maß ich ungefähr sechs Sekunden, dann fünf, dann sechs, dann vier bei einem späteren Versuch, schlechter als mein Testlauf am Tag zuvor. Die Ursache habe ich nicht gefunden. Die Kostenseite hat perfekt gehalten, an der Latenz muss noch gearbeitet werden.
Abschließender Gedanke
Die Kernbehauptung hat gehalten: Eine Java-App auf Cloud Run kann auf null skalieren und im Leerlauf nichts kosten, zweimal auf der echten Billing-Seite geprüft. Überraschend war, wo der KI-gesteuerte Workflow gebrochen ist. Nicht bei der Infrastruktur, der Deploy-Pipeline oder Firestore, all das lief ohne Drama über einen Prompt, sondern bei dem einen Schritt, den Google selbst hinter einem manuellen Klick versteckt: dem Anlegen des OAuth-Clients. Genau dort häuften sich danach die Bugs. Wer sein komplettes Deployment einem KI-Agenten überlässt, sollte trotzdem einen Tab für die Konsole einplanen.
Nützliche Links
- Quarkus-OIDC-Guide: Konfiguration von
quarkus-oidcmit eingebauten Providern wie Google - Quarkus Google Cloud Services (Quarkiverse): die Firestore-Extension für die Datenhaltung, inklusive lokalem Emulator als Dev Service
- Cloud-Run-Preise: die Always-Free-Stufe, innerhalb derer diese Session geblieben ist
- Die BMad-Methode für Java-Entwickler: mein übliches KI-Workflow-Toolkit, hier ausgelassen, weil es für einen einzelnen Stream zu aufwendig ist
Kommentare
Kommentare optional von GitHub laden
Die Kommentarfunktion wird über Giscus und GitHub Discussions bereitgestellt. Sie wird erst nach Ihrer ausdrücklichen Einwilligung geladen. Beim Laden können personenbezogene Daten wie Ihre IP-Adresse und technische Metadaten an GitHub übermittelt sowie Cookies oder ähnliche Technologien gesetzt werden.
Bitte bestätigen Sie zuerst Ihre Einwilligung, bevor die Kommentare geladen werden.