Heimdeck, Auswärtsdeck: Ein Karten-Klassifikator in Java mit JobRunr
mit Ronald DehuysserMit Ronald Dehuysser, dem Erfinder von JobRunr, habe ich einen Bildklassifikator für 20 Java-Sammelkarten trainiert, ohne Java zu verlassen. Das Training lief als JobRunr-Hintergrundjob, die Erkennung als einfacher synchroner Aufruf. Diese Aufteilung hat funktioniert. Das Modell nur halb, denn es hatte ein Deck in einem Zimmer gelernt und wurde mit einem anderen getestet.
YouTube
Heimdeck, Auswärtsdeck: Ein Karten-Klassifikator in Java mit JobRunr
YouTube-Video laden
Dieses Video wird von YouTube eingebettet und erst nach Ihrer Einwilligung geladen. Beim Laden können personenbezogene Daten an YouTube oder Google übermittelt und Cookies gesetzt werden.
Mehr dazu in der Datenschutzerklärung.
Projektquelle
Arbeits-Repository
Hier findest du Prompts, Instructions und Beispiele aus dem gezeigten Modernisierungs-Workflow.
Repository öffnenTimestamps der Session
- 00:00Einführung
- 02:38Warum Ronald JobRunr gebaut hat
- 07:02Von AlexNet zu unserem Plan für den Karten-Klassifikator
- 12:38Das Repo, 20 Karten und echte Webcam-Bilder
- 19:04Den Code fürs Live-Coding leeren
- 29:29Ein KI-Agent schreibt den Vorbereitungsjob
- 45:10Jobs, Job-Kontext und Wiederholungen in JobRunr
- 48:48Background-Job-Server und Skalierung auf Kubernetes
- 54:39CO₂-bewusste Job-Planung
- 01:00:04Wechsel zum fertigen Code und Reparatur des Builds
- 01:09:10Prepare- und Train-Job starten
- 01:13:09JobRunr gegen Temporal und die H2-Datenbank
- 01:22:14Datenbanktabellen, Performance und JobRunr Pro
- 01:29:00Wie der Train-Job mit DJL und ResNet 18 arbeitet
- 01:36:50Live-Test der Kartenerkennung
- 01:46:57Wechsel zu Postgres
- 01:53:27Hibernate-Gespräch und Abschluss
Ein Modell zu trainieren dauert Minuten. Eine Karte zu erkennen dauert einen Aufruf. Behandelt eine Java-App beides gleich, wartet am Ende ein Nutzer auf einen Trainingslauf. In dieser Session ging es darum, beides zu trennen. Den langsamen Teil haben wir in einen JobRunr-Hintergrundjob gesteckt, der schnelle Teil blieb synchron, alles in Java.
Co-Speaker
Ronald Dehuysser
Erfinder bei JobRunr
Ronald ist Entwickler aus Belgien. Er startete JobRunr 2020, nach einem verteilten Java-Projekt für Rechnungen mit mehr Nano-Services als Entwicklern, ohne Correlation-IDs und mit Rechnungen, die in einer Dead Letter Queue verloren gingen.
Das Deck
Für die Session habe ich 20 eigene Sammelkarten über die Java-Welt gemacht, im Stil eines Quartetts. Das Deck reicht von Duke und JobRunr bis zum Garbage Collector, zur NullPointerException und zu einem Legacy-Monolithen. Das Ziel war einfach: Karte vor die Webcam halten, und die App nennt sie.
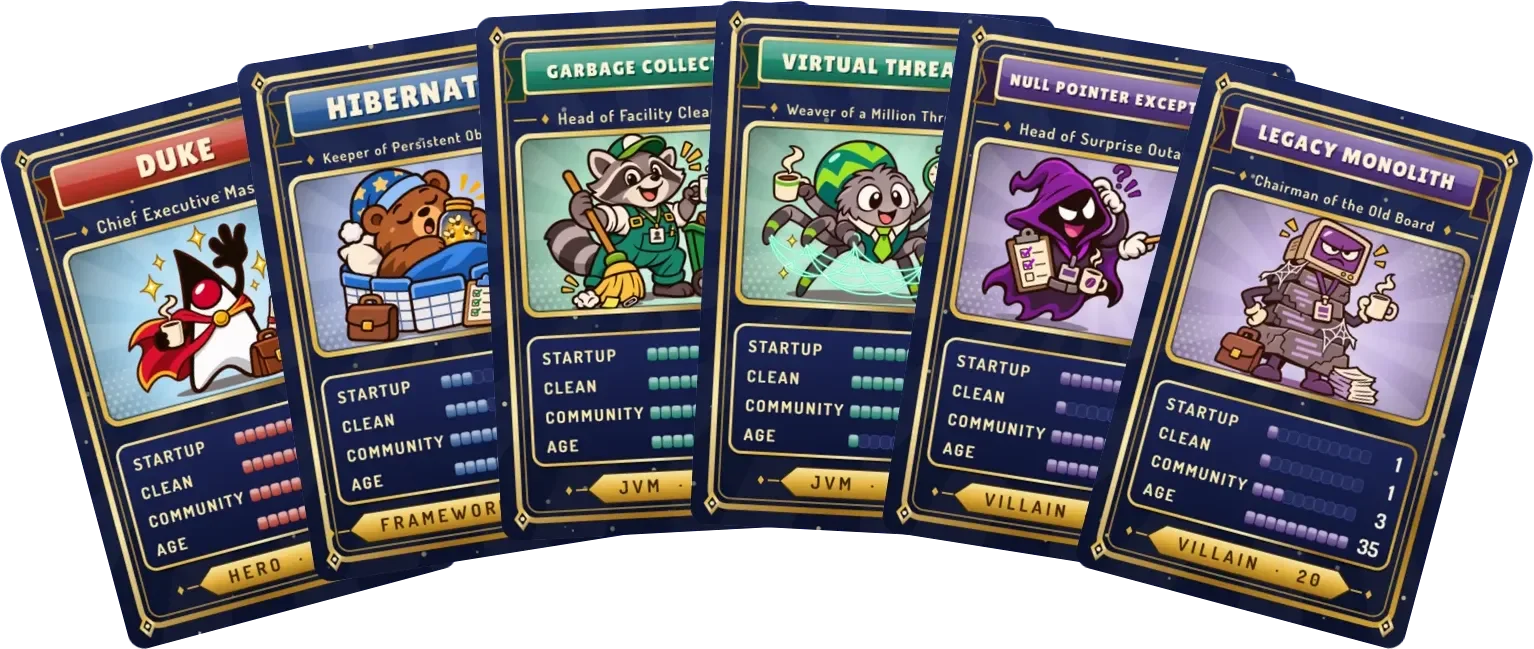
Die Trainingsbilder hat Ronald selbst aufgenommen. Er hielt jede Karte vor seine Webcam und drückte 20 bis 30 Mal pro Karte einen Knopf. Dieses Detail sollte man sich merken. Es entscheidet, wie die Geschichte ausgeht.
Zwei Geschwindigkeiten
Die App hat zwei Aufgaben, und die laufen sehr unterschiedlich schnell.
Training ist langsam. Ein Prepare-Job teilt die Fotos etwa 80/20 in Trainings- und Validierungsdaten auf und schneidet sie auf ein kartenförmiges Format zu. Ein Train-Job durchläuft dann die Epochen und meldet am Ende Genauigkeit und Loss. Im Stream dauerte das Training etwa 24 Minuten. Auf Ronalds Rechner waren es etwa 10.
Erkennung ist schnell. Ein Webcam-Bild geht ins trainierte Modell, ein Kartenname kommt heraus. Das bleibt ein einfacher synchroner Aufruf. Kein Job, keine Queue, kein Warten.
JobRunr nimmt den langsamen Teil aus dem Web-Request. Der Request antwortet sofort, und das Dashboard zeigt die Logs des Jobs und einen Fortschrittsbalken. Der kommt allerdings nicht von allein.
Den Fortschritt musst du selbst pflegen, denn JobRunr weiß nicht, wie lange der Job dauert oder was darin überhaupt passiert.
Der Trainingscode meldet seinen Fortschritt also selbst über den Job-Kontext. Dafür bekommt man eine Live-Ansicht eines 24-Minuten-Jobs statt eines hängenden Browser-Tabs.
Transfer Learning, ohne Java zu verlassen
Niemand hat ein neuronales Netz von Grund auf trainiert. DJL, die Deep Java Library, lädt ResNet 18 herunter, ein vortrainiertes Bildmodell mit 18 Schichten. Wir haben nur einen kleinen Klassifikationskopf für unsere 20 Karten darauf trainiert. Dieser Kopf landet in einer eigenen Datei, head.jd, neben dem unveränderten Standardmodell.
Ronald hat ResNet 18 statt ResNet 50 gewählt, weil es auch auf schwächerer Hardware läuft. DJL bindet die C-Bibliothek von PyTorch über JNI hinter einer Java-API ein. Kein Python, kein zusätzlicher Dienst. Ronald nannte Qwen Vision als Alternative, aber dessen Fine-Tuning hätte bedeutet, Java zu verlassen.
Für Java-Entwickler ohne ML-Hintergrund ist das der nützliche Teil. Man braucht ein vortrainiertes Modell, ein paar hundert Fotos und einen Job-Runner, keinen neuen Tech-Stack.
Was JobRunr um den Job herum mitbringt
Während das Modell trainierte, zeigte Ronald, was JobRunr über das Ausführen einer Methode im Hintergrund hinaus kann.
- Wiederholungen: Ein fehlgeschlagener Job wird standardmäßig 10 Mal mit exponentiellem Back-off wiederholt. Die Annotation
@Jobsetzt Name, Wiederholungen, Labels und Job-Filter. - Background-Server: Eine Property macht eine Instanz zum Background-Job-Server. Man deployt dasselbe Jar zweimal, und eine versteckte Instanz erledigt die schwere Arbeit, während die Web-Instanz schnell bleibt. Am Black Friday, sagte Ronald, kann KEDA zusätzliche Pods hochfahren.
- Geteilte Datenbanken: Apps mit einer gemeinsamen Datenbank brauchen eigene Tabellenpräfixe. Sonst greift ein Server Jobs ab, deren Klassen er nicht kennt.
- Last: Stresstests erreichen etwa 5.000 Jobs pro Sekunde auf Postgres, MariaDB und MongoDB. Eine Firma lässt 8 Milliarden Jobs im Jahr darüber laufen.
Ich fragte, wie sich JobRunr von Temporal unterscheidet, das ich in einer früheren Session mit Les Jackson ausprobiert hatte. Temporal ist sprachunabhängig. JobRunr lebt in der eigenen Anwendung. Stirbt die JVM, stoppen auch die Jobs, aber Kubernetes startet den Pod neu, und JobRunr macht dort weiter, wo es aufgehört hat.
Hier musst du nicht dein Infrastrukturteam fragen: Hey, darf ich Temporal installieren? Denn Temporal ist wieder ein zusätzliches Stück Infrastruktur, das du betreiben musst und für das du manchmal sogar Leute einstellen musst.
Die größte Überraschung war die CO₂-bewusste Planung. Man gibt einem Job ein Zeitfenster, und JobRunr führt ihn aus, wenn die CO₂-Intensität im Stromnetz am niedrigsten ist. Laut Ronald hat sein Team herausgefunden, dass CO₂-Ausstoß und Strompreis in 99,9 % der Fälle zusammenhängen.
Heimdeck, Auswärtsdeck
Dann kam der Webcam-Test. Meine erste Karte wurde erkannt. Danach waren die meisten Antworten falsch oder sprangen zwischen Karten hin und her, auf meinem Rechner wie auf Ronalds. Der Legacy-Monolith kam bei mir auf 68 %, bei ihm auf 100 %.
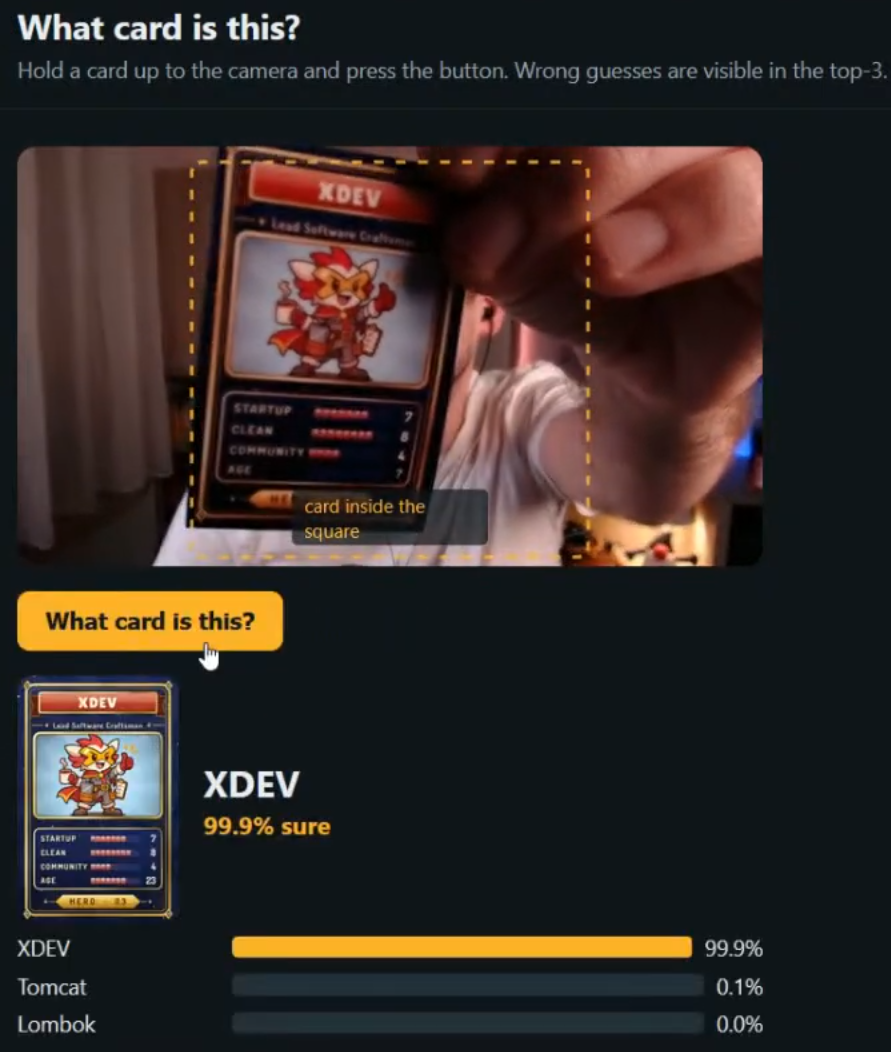
Wenn es traf, dann mit voller Überzeugung: XDEV mit 99,9 %. Das Problem war, wie selten das passierte.
Das Modell hatte das Heimdeck gelernt: Ronalds Ausdrucke, in Ronalds Zimmer, unter Ronalds Licht. Dann musste es auswärts spielen, mit meinen Ausdrucken, meinem Zimmer und meinem Licht. Mögliche Ursachen haben wir im Stream gesammelt, getestet haben wir keine:
- ein anderes Zimmer und anderes Licht
- meine Ausdrucke sehen anders aus als Ronalds
- viele Karten haben ähnliche Farben, etwa die blauen
- nur etwa 30 Fotos pro Karte
Die Pipeline hat ihren Job gemacht. Die Trainingsdaten waren zu einseitig. Ronalds Lösung: abwechslungsreichere Bilder erzeugen und neu trainieren. Im Stream haben wir nicht neu trainiert.
Was sonst schiefging
Der Plan war, den fertigen Code zu löschen und mit einem KI-Agenten neu zu bauen. Das hat nicht geklappt. Der erste Agent stellte immer wieder dieselbe Frage und löschte eine Klasse. Sonnet schrieb danach die Vorbereitungsmethode, verschob und löschte aber auch Dateien, um die ich nicht gebeten hatte. Nach etwa einer Stunde wechselten wir zum fertigen Code auf dem Main-Branch. Ich erkläre lieber funktionierenden Code, als einem LLM beim Schreiben des Rests zuzusehen.
Fazit
Langsame Arbeit gehört in einen Job. Das Training lief 24 Minuten als JobRunr-Hintergrundjob, mit Fortschritt und Logs im Dashboard. Die Erkennung blieb ein synchroner Aufruf. DJL hielt alles in Java. Diese Aufteilung hat im Stream gehalten, auch als das Modell es nicht tat.
Wer so etwas baut, fängt mit einem vortrainierten Modell an und packt das Training in einen Job. Und testet mit einem Deck aus einem anderen Zimmer, bevor er der Genauigkeit traut.
Nützliche Links
- JobRunr, die Bibliothek für Hintergrundjobs in Java
- JobRunr auf GitHub, der Open-Source-Kern
- JobRunr: Logging und Job-Fortschritt, wie ein Job seinen Fortschrittsbalken selbst steuert
- JobRunr: CO₂-bewusste Jobs, Planung im Zeitfenster mit der niedrigsten CO₂-Intensität
- JobRunr Pro, die kostenpflichtige Version mit Prioritäts-Queues, Workflows und Job-Suche
- DJL-Tutorial zu Transfer Learning, dieselbe Idee mit einem vortrainierten ResNet und der PyTorch-Engine
- Deep Residual Learning for Image Recognition, das Paper hinter ResNet
- Meine Temporal-Session mit Les Jackson, robuste Workflows mit der sprachunabhängigen Alternative, mit der wir verglichen haben
- Hangfire, die .NET-Bibliothek, die Ronald auf die Idee für JobRunr brachte
Kommentare
Kommentare optional von GitHub laden
Die Kommentarfunktion wird über Giscus und GitHub Discussions bereitgestellt. Sie wird erst nach Ihrer ausdrücklichen Einwilligung geladen. Beim Laden können personenbezogene Daten wie Ihre IP-Adresse und technische Metadaten an GitHub übermittelt sowie Cookies oder ähnliche Technologien gesetzt werden.
Bitte bestätigen Sie zuerst Ihre Einwilligung, bevor die Kommentare geladen werden.